VALIDIERTE GENAUIGKEIT · OFFENE METHODIK
SomniSense-Genauigkeit: Was wurde wirklich geprüft?
Die Genauigkeit von 88.49% betrifft die Einteilung von 200-Sekunden-Forschungsfenstern in normal oder Apnoe/Hypopnoe enthaltend, keine OSA-Diagnose bei Personen. Der Datensatz umfasst 2953 Fenster aus 80 Personennächten von 40 Teilnehmenden. Paper E bewertet die Kompression mit einem einzelnen Zufallsstartwert. App-Kandidaten bleiben prüfbare Beobachtungen, keine bestätigten klinischen Ereignisse oder persönliche Genauigkeitsgarantie.
Paper A berichtet 91.67% Sensitivität und 89.01% Präzision als Mittelwerte aus fünf Zufallsstartwerten für 13538 markierte Einsekunden-Schnarchsegmente. Das sind keine OSA-Patientenmetriken. Paper A
Illustration, keine Studiendaten. Die untersuchte Stichprobe wird im Text beschrieben.
WAS SOMNISENSE ERGÄNZT
Was die Zahl für die Stelle bedeutet, die Sie morgen öffnen.
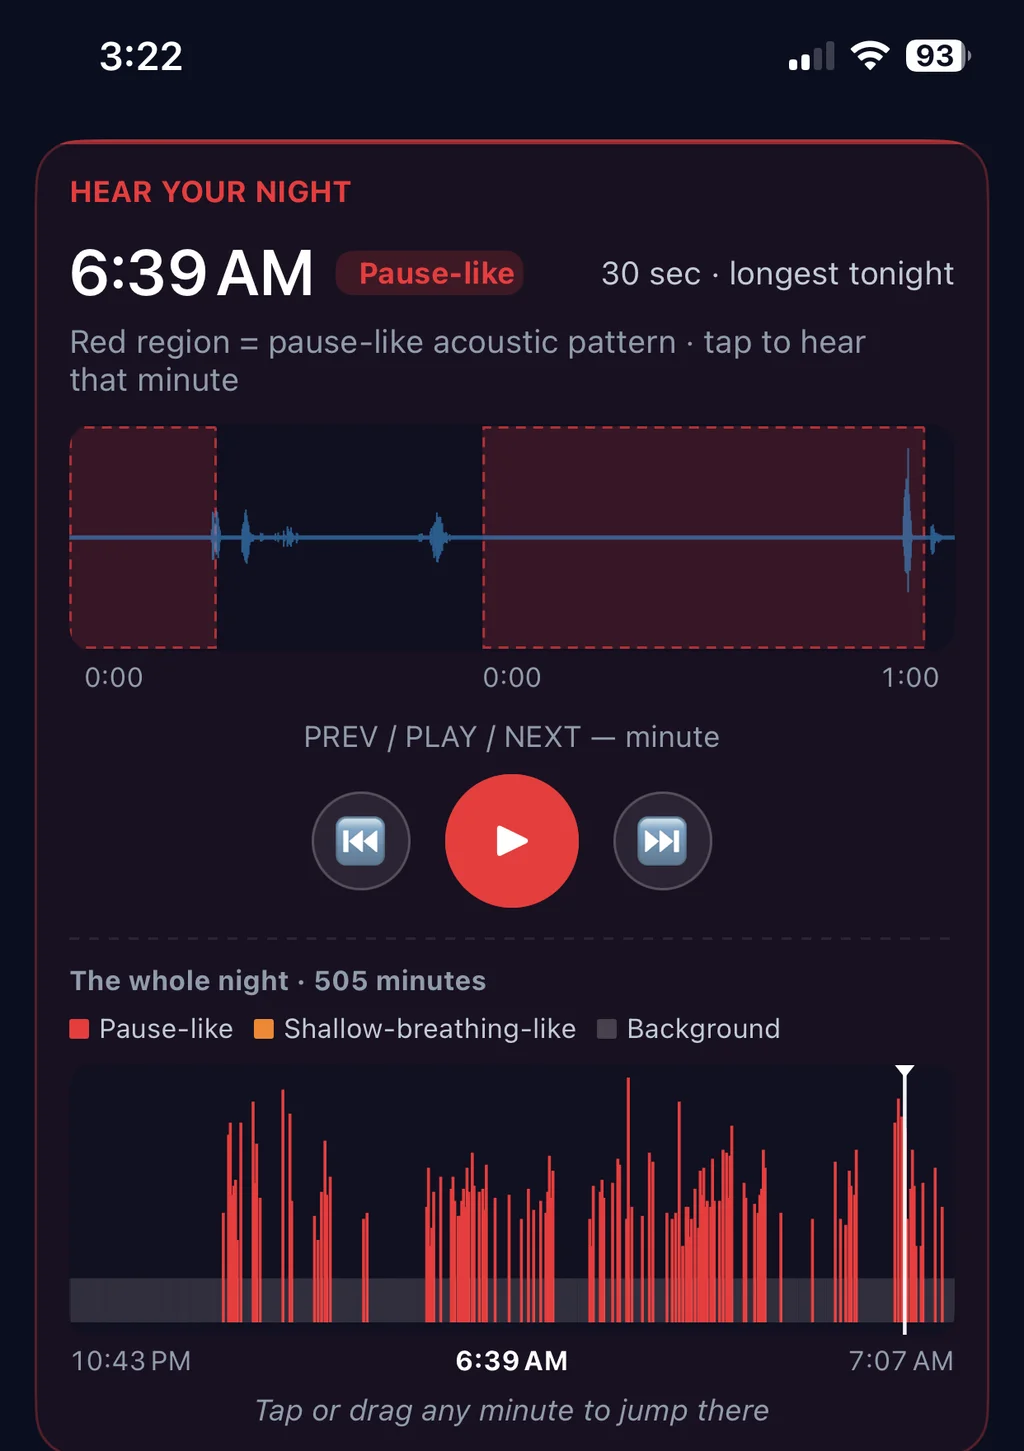
Dieser echte App-Bildschirm zeigt eine mögliche Atempause zum Nachprüfen: geschätzte Zeit und Dauer, markierte Wellenform, Wiedergabe und Position in der Nacht. Hören Sie den Ton davor und den wieder einsetzenden Ton an. Der Benchmark für 200-Sekunden-Fenster bestätigt nicht, dass jede markierte Pause, Dauer oder persönliche Auswertung klinisch richtig ist.
- Pausenähnliches oder flachatmungsähnliches Kandidatenmuster, Zeitpunkt und modellgeschätzte Dauer
- Markierte Wellenform und Wiedergabe der Geräusche vor und nach dem Kandidatenabschnitt
- Position innerhalb der gesamten Nacht, über mehrere Nächte hinweg in aktuellen Vergleichen und strukturierten Berichten verfolgt
Smartphone-Audio ist ein begrenztes Wellness-Signal. Kandidatenbereiche sind keine klinischen Apnoe-Ereignisse, kein AHI, keine Sauerstoffmessungen, keine Befunde zum Ursprung in den Atemwegen und keine Diagnose.
Warum die Aufgabendefinition zuerst kommt
Die aktuelle Forschung ist als offener Preprint verfügbar und hat die Begutachtung durch Fachkollegen noch nicht abgeschlossen. Jede hervorgehobene Zahl gehört zu einer bestimmten gekennzeichneten Aufgabe, einem Datensatz und einem Bewertungsverfahren.
Daher nennen wir die Aufgabe direkt neben der Metrik und übertragen ein Benchmark-Ergebnis nicht auf Ereignisgrenzen, Dauern, Produktkennzeichnungen, einzelne Schlafzimmer oder klinische Diagnosen. Ändert eine spätere Begutachtung oder erweiterte Validierung ein Ergebnis, wird diese Seite aktualisiert.
Das Problem einer einzigen Zahl
Ein einzelner gerundeter Prozentsatz für „genau“ ist unvollständig, bis Sie fragen: genau bei was, in welcher Population und gegenüber welchen Referenzkennzeichnungen? Schnarchsegmentklassifikation, Atemfensterklassifikation, Produktionsereignisgrenzen und ein Index für die ganze Nacht sind verschiedene Fragen mit unterschiedlicher Evidenz.
SomniSense unterteilt Genauigkeit in mehrere Zahlen, die jeweils an eine konkrete Frage gebunden sind. Kein einzelner Benchmark erzählt die gesamte Produktgeschichte.
Zwei Indizes, eine App — und warum die Validierungszahlen so getrennt sind
SomniSense erzeugt jede Nacht zwei produktdefinierte Indizes. Die zugrunde liegenden Modellbenchmarks bewerten verschiedene Aufgaben:
- Der BRI ist eine produktspezifische Kandidatenrate. Paper E nennt 88.49% Genauigkeit und 88.06% F1 für 200-Sekunden-Fenster (2953 insgesamt; ein Zufallsstartwert). Pruned+FT+QAT hat 9416 Parameter und 56.4 KB Dateigröße. Die separate CoreML-Pruned+FT-Konfiguration benötigt auf Apple M2 0.064 ms je Vorwärtslauf, ohne Audiovor- und Nachverarbeitung (200 Aufrufe, 20 zum Aufwärmen).
- SRI (Snoring Rate Index) — Schnarchereignisse pro Stunde. Der zugrunde liegende Benchmark für 1-Sekunden-Schnarchereignisse berichtet 91.67% Sensitivität und 89.01% Präzision.
BRI und SRI sind beide produktdefinierte Wellness-Indizes. BRI ist nicht AHI, und der Benchmark zur Fensterklassifikation validiert nicht unabhängig jedes Ereignis, aus dem ein nächtlicher Index zusammengesetzt wird.
Was unsere Forschung misst und was BRI tatsächlich tut
Drei verschiedene Dinge werden oft vermischt. Wir versuchen, sie auseinanderzuhalten:
- Fensterklassifikation (was Paper E validiert). Ein gekennzeichnetes 200-Sekunden-Fenster mit Nachttisch-Audio wird vom Modell als normal oder als Apnoe oder Hypopnoe klassifiziert. Produktionsbenchmark: 88.49% Genauigkeit und 88.06% F1.
- BRI pro Nacht (was die App jeden Morgen berichtet). Die App aggregiert Kandidatenereignisse der Produktion über die Sitzung:
BRI = Kandidatenereignisse für Atemunregelmäßigkeiten / geschätzte Schlafstunden. Dies ist eine produktdefinierte akustische Rate, kein klinischer AHI. - OSA-Diagnose (Obstructive Sleep Apnea) — was eine Schlafmedizinerin oder ein Schlafmediziner tut, nicht SomniSense. Eine klinische Diagnose auf Grundlage von Polysomnographie, Bewertung der Tagessymptome und ärztlichem Urteil. BRI sind Daten; die OSA-Diagnose ist ärztliche Entscheidung.
Ereignisbeginn, Ereignisende, Dauer, Produktkennzeichnung, nächtlicher BRI und persönliche Trends sind Ausgaben der aktuellen App. Sie sollten nicht als durch das 200-Sekunden-Fensterergebnis unabhängig validiert beschrieben werden, sofern keine separate veröffentlichte Analyse genau diese App-Ausgabe bewertet.
Die Benchmark-Zahlen, die wir tatsächlich veröffentlichen
| Die Frage | Die Zahl | Was sie bedeutet |
|---|---|---|
| Wie viele der gekennzeichneten Schnarchsegmente hat der Detektor erfasst? | 91.67% | Sensitivität (Recall) für Schnarchereignisse in 1-Sekunden-Segmenten; Mittelwert aus fünf Seeds. |
| Wie oft lag der Detektor richtig, wenn er ein Schnarchsegment markierte? | 89.01% | Präzision für Schnarchereignisse in 1-Sekunden-Segmenten; Mittelwert aus fünf Seeds. |
| Wie oft klassifizierte das komprimierte Atemmodell ein gekennzeichnetes Fenster korrekt? | 88.49% | Genauigkeit des Produktionsbenchmarks für die Klassifikation normal gegenüber Apnoe oder Hypopnoe in 200-Sekunden-Fenstern. |
| Wie ausgewogen war die Leistung der Atemfenster über die Klassen hinweg? | 88.06% | F1 für denselben komprimierten Produktionsbenchmark. Paper E veröffentlicht kein Paar aus Produktionssensitivität und -präzision; daher leiten wir keines ab. |
Der Forschungskorpus umfasst 80 gekoppelte PSG-Nächte von 40 Teilnehmenden (10 im Labor + 70 ambulante PSG mit Nasenflusskanüle). Den verlinkten Preprints können Sie entnehmen, welche Teilmenge, Kennzeichnungen und Bewertungsverfahren für die jeweilige berichtete Metrik gelten.
Die Arbeiten beschreiben PSG-basierte Referenzlabels. Ein verblindetes Bewertungsverfahren oder eine unabhängige prospektive klinische Prüfung ist nicht dokumentiert.
Wie wir getestet haben (die Methodik, verständlich)
Illustration, keine Studiendaten. Die untersuchte Stichprobe wird im Text beschrieben.
Paper A untersucht retrospektiv die Klassifikation anhand von PSG-Labels; Paper E bewertet die Kompression auf abgeleiteten Merkmalen. Damit ist keine klinische Screening-Leistung belegt.
Konkret:
- Stichprobe: 80 Personennächte von 40 Teilnehmenden, davon 10 Labor-PSG- und 70 ambulante PSG-Nächte. Systematische Leistungen nach Bevölkerungsgruppe werden nicht berichtet.
- Die Aufnahmen stammen von verschiedenen handelsüblichen Smartphone- und Tablet-Mikrofonen in unterschiedlichen Räumen. Gerätespezifische Leistung und ein fester Aufnahmeabstand sind nicht belegt.
- Referenz: Tonaufnahmen mit zugeordneten PSG-Ereignislabels. Die Quellen dokumentieren weder konkrete Qualifikationen der Auswertenden noch ein Verblindungsverfahren.
- Veröffentlichte Vergleiche: aufgabenspezifische Metriken für Schnarchsegment- und Atemfensterklassifikation. Produktionsereignisgrenzen und nächtliche Indizes benötigen eigene Bewertungen und übernehmen diese Ergebnisse nicht stillschweigend.
Der Algorithmus zur Erkennung von Atemereignissen baut auf der jahrelangen Schlafapnoe-Forschung unseres Gründers auf. Die in SomniSense eingesetzte Version wurde von Grund auf neu trainiert und für SomniAI LLC speziell für Smartphone-Audio neu entwickelt — anderes Mikrofon, anderer Abstand und anderer akustischer Kontext als bei klinischer Hardware. Drei begleitende Preprints dokumentieren die Methodik vollständig: der Preprint zu kaskadierten Baselines (Multi-Seed-bootstrap), der Preprint zur Coordinate-Attention 1D-Architektur (93.2% weniger Parameter) und der Preprint zur Kompression auf dem Gerät (0.064 ms Inferenz auf Apple Neural Engine). Alle sind offen auf Zenodo mit zitierfähigen DOIs veröffentlicht (cs.LG, eess.AS). Wie das zweistufige System zusammenspielt und das gesamte Preprint-Portfolio finden Sie im Forschungsprogramm. Der vollständige technische Hub — Architektur im Detail, SDK und Lizenzierung für Hardware- und klinische Partner — befindet sich auf apneasense.com/research.
Ehrliche Grenzen
Folgendes wissen wir noch nicht — und ich würde es als Nutzer wissen wollen:
- Die Kohorte repräsentiert nicht alle Menschen. Die Leistung für Einzelpersonen oder eine unterrepräsentierte Population kann abweichen; wir nehmen nicht an, dass das veröffentlichte Gesamtergebnis für eine bestimmte Person konservativ ist.
- Die akustische Umgebung ist wichtig. Hat Ihr Schlafzimmer ungewöhnliche akustische Eigenschaften — harte Oberflächen, einen lauter schnarchenden Partner oder einen direkt auf das Smartphone gerichteten Ventilator —, kann das Modell weniger Ihrer Ereignisse erfassen. Das Methodenpapier dokumentiert die getesteten Bedingungen.
- Jede Ausgabe der aktuellen App benötigt eine eigene Validierung. Ein Fensterbenchmark kann nicht die Genauigkeit jeder in der App gezeigten Ereignisgrenze, Dauer, Kennzeichnung, jedes BRI-Werts oder Trends belegen.
- Nicht für unter 18-Jährige validiert. Die Kohorte umfasste nur Erwachsene.
- Preprints, noch nicht begutachtet. Drei begleitende Preprints sind offen auf Zenodo mit zitierfähigen DOIs veröffentlicht; eine Publikation in einer begutachteten Fachzeitschrift ist ein separater Prozess und wird nach Abschluss auf dieser Seite vermerkt.
Was dies nicht ist
- SomniSense diagnostiziert OSA nicht und führt kein OSA-Screening durch. Eine klinische Abklärung kann PSG oder einen geeigneten häuslichen Test umfassen. Die App ist unter 18 Jahren nicht validiert.
- Keine persönliche Garantie. Ihre konkreten Ergebnisse können von Bevölkerungsdurchschnitten abweichen. Lesen Sie das Methodenpapier, um zu erkennen, ob Ihr Szenario innerhalb oder außerhalb der Verteilung liegt.
- Kein Ersatz für eine Schlafuntersuchung. Wenden Sie klinische AHI-Schwellenwerte nicht auf BRI an. Symptome oder Sorgen verdienen unabhängig vom App-Wert eine professionelle Abklärung.
Unsicher, ob dies Ihr Problem ist? Bei einem Symptom beginnen
Wenn Sie die Evidenz prüfen möchten, bevor Sie der App vertrauen, führt ein anderer Einstieg über das, was Sie tatsächlich spüren. Jede Seite erläutert das Atemmuster hinter dem Symptom und mögliche nächste Schritte:
Wenn Ihnen dieses Evidenzniveau genügt
Free bietet grundlegende Hinweise der ersten Nacht, lokale Wiedergabe innerhalb der App-Limits und einen 7-Tage-Rückblick. Pro ergänzt längere Aufzeichnungen; die erste Nacht selbst nachzusehen bleibt Teil von Free. Kaufdetails stehen auf der Preisseite.
Mit Free beginnen Jeden Benchmark und seine Grenze prüfen →